segunda-feira, 6 de agosto de 2012

MultiModel forms, parte 3: Nested Forms

Este post é o terceiro de uma série de quatro artigos:
O código desta aplicação de exemplo está disponível neste repositório Github.

Nested Forms

Nos dois primeiros posts desta série, foi mostrado o poder do uso de Nested Models. O Rails fornece ainda helpers para a construção de views com este recurso. Usamos estes helpers para reescrever o arquivo app/views/people/_form.html.erb (criado via scaffolding, no primeiro post):
<%= form_for(@person) do |f| %>
  <div class="field">
    <%= f.label :name %><br />
    <%= f.text_field :name %>
  </div>

  <%= f.fields_for :user_account do |acc| %>
    <div class="field">
      <%= acc.label :username %><br />
      <%= acc.text_field :username %>
    </div>
    <div class="field">
      <%= acc.label :password %><br />
      <%= acc.password_field :password %>
    </div>

    <%= acc.fields_for :permissions do |p| %>
      <div class="field">
        <%= p.label p.object.restricted_area %>
        <%= p.hidden_field :restricted_area %>
        <%= p.select :grants, [ "Read-Only", "Read-Write", "Read-Write-Delete" ], include_blank: true %>
      </div>
    <% end %>
  <% end %>

  <div class="actions">
    <%= f.submit %>
  </div>
<% end %>
Entre na tela de cadastro (http://localhost:3000/people/new), para visualizar um formulário contendo os campos de Person, UserAccount e Permission:

Oops. Apenas os campos de Person estão visíveis. Não é difícil conjecturar o porquê. Ao criar um novo objeto Person, ele não possui um user_account, como pode ser confirmado no console:
> Person.new.user_account
 => nil
É necessário sobrescrever o método Person/user_account, para que retorne um novo objeto quando Person não tiver uma conta de usuário associada:
  def user_account
    @user_account = super
    @user_account = build_user_account if @user_account.nil?
    @user_account
  end
Isto é suficiente para habilitar os campos de UserAccount:


Para exibir os campos referentes aos atributos de Permission, criamos um método UserAccount/permissions_types, que pré-instancia as possíveis opções:
  def permissions_types
    hash = {}
    permissions.each { |p| hash[p.restricted_area] = p }

    [ "admin", "backups", "logs" ].each { |area|
      hash[area] = Permission.new restricted_area: area unless hash.has_key? area
    }
    hash.values
  end
Note que as duas primeiras linhas "memorizam" associações previamente salvas, enquanto nas linhas seguintes, são construídos novos objetos apenas para as associações que ainda não estiverem presentes.

É necessário modificar o formulário para construir os campos de permissões utilizando este método:
<%= acc.fields_for :permissions, acc.object.permissions_types do |p| %>
  <div class="field">
    <%= p.label p.object.restricted_area %>
    <%= p.hidden_field :restricted_area %>
    <%= p.select :grants, [ "Read-Only", "Read-Write", "Read-Write-Delete" ], include_blank: true %>
  </div>
<% end %>
Vejamos como ficou:

Agora que os campos já estão presentes no formulário, basta salvar um registro:

Oops... estamos quase lá... Vamos tentar entender o que aconteceu. Com auxílio do Chrome Developer Tools, podemos analisar os dados que são submetidos com o formulário:


Os view helpers do Rails criam campos com nomes que são adequados à sua forma de processar nested models. Se analisarmos o log do controller, vemos que o request foi convertido para um hash, representando estes parâmetros de forma hierárquica (formatei o log para facilitar sua visualização):
Started POST "/people" for 127.0.0.1 at 2012-08-05 22:36:11 -0300
Connecting to database specified by database.yml
Processing by PeopleController#create as HTML
Parameters: {
  "utf8"=>"✓", 
  "authenticity_token"=>"iTFVyyIwp0w2apXT02s+XN3z6PfOFEuUgZRaZWxPegU=",
  "person"=>{
    "name"=>"José da Silva",
    "user_account_attributes"=>{
      "username"=>"jsilva",
      "password"=>"[FILTERED]",
      "permissions_attributes"=>{
        "0"=>{
          "restricted_area"=>"admin",
          "grants"=>"Read-Only"
        },
        "1"=>{
          "restricted_area"=>"backups",
          "grants"=>""
        },
        "2"=>{
          "restricted_area"=>"logs",
          "grants"=>"Read-Write"
        }
      }
    }
  },
  "commit"=>"Create Person"
}
Faz sentido: o rails tentou criar uma permission com o campo grants em branco, mas este campo é obrigatório (vide a parte 2 desta série). É necessário alguma forma de filtrar de permission_attributes os valores que estiverem com grants em branco. Há: Rails possui essa facilidade:
accepts_nested_attributes_for :permissions, allow_destroy: true,
  reject_if: proc { |attrs|
    attrs["grants"].blank?
  }
Basta este pequeno ajuste em UserAccount para conseguimos salvar o registro, que na figura abaixo, foi reaberto para edição:


É incrível: simplesmente funciona! Tudo bem até aqui, já conseguimos salvar. Mas logo descobrimos que o "brinquedo quebra" se tentar remover uma permissão: tente deixar Logs em branco e salvar. Parece que tudo deu certo, mas ao reabrir para edição, a permissão continua lá.

Isto ocorre pois, após termos adicionado a cláusula reject_if, as permissões em branco passaram a ser rejeitadas. O Rails não tem mais a oportunidade de processá-las. Além disso, vimos nos posts anteriores que, para remover um nested model, é necessário passar _destroy: true como um de seus parâmetros.

Pode-se usar um checkbox para adicionar um atributo _destroy:
<%= acc.fields_for :permissions, acc.object.permissions_types do |p| %>
  <%= p.label p.object.restricted_area %>
  <%= p.hidden_field :restricted_area %>
  <%= p.select :grants, [ "Read-Only", "Read-Write", "Read-Write-Delete" ], include_blank: true %>
  <% unless p.object.new_record? %>
    <%= p.check_box :_destroy %>
    <%= p.label :_destroy, 'Remove' %>
  <% end %>
<% end %>
O formulário fica com a seguinte aparência:


E agora, com auxílio do checkbox, conseguimos também remover permissões. Um único formulário, manipulando uma complexa estrutura de dados associados - Person 1 : 1 UserAccount 1 : N Permission.

Note que não foi necessário adicionar nenhuma lógica no controller para interpretar argumentos do request dos objetos associados. Apesar de termos sido obrigados a adicionar um checkbox para remoção de permissões, não precisamos de nenhuma lógica customizada de data-binding para apresentar as associações na view. Tudo out-of-the-box, prontinho para usar, um bonus-track desta fantástica framework web que é o Rails!

No quarto e último post desta série, será mostrada "a cereja do bolo": com um pouquinho de JavaScript, jQuery e Knockout.js, tornaremos a adição de permissões mais dinâmica, além de adicionar dinamicamente o atributo _destroy no request, sem precisar de um checkbox.


Referências

domingo, 5 de agosto de 2012

MultiModel forms, parte 2: One-To-Many

Este post é o segundo de uma série de quatro artigos:
O código desta aplicação de exemplo está disponível neste repositório Github.

Nested Models - One-to-Many

Segue o modelo utilizado neste tutorial:
  • Person has one UserAccount (parte 1)
  • UserAccount has many Permissions (parte 2)

Conforme estabelecido na parte 1 desta série, queremos editar UserAccount a partir do model Person. Nesta segunda parte, veremos como editar também a partir do model Person a associação one-to-many UserAccount / Permissions. O modelo de permissões será bem simples:

rails g model Permission user_account_id:integer restricted_area:string grants:string

rake db:migrate


Por fim, resta configurar as validações e relacionamentos nos respectivos models.

Nested One-to-Many

É necessário adicionar uma cláusula has_many em UserAccount, para que esta possa navegar na associação um-para-muitos. Permission possui a chave estrangeira user_account_id (lado belongs_to). Por fim, configuramos UserAccount para aceitar também os atributos da associação Permission.

class UserAccount < ActiveRecord::Base
  attr_accessible :password, :username, :permissions_attributes
  validates_presence_of :username, :password, :person
  belongs_to :person
  has_many :permissions, inverse_of: :user_account
  accepts_nested_attributes_for :permissions, allow_destroy: true
end

class Permission < ActiveRecord::Base
  attr_accessible :restricted_area
  validates_presence_of :user_account, :restricted_area, :grants
  belongs_to :user_account
end


Façamos alguns testes no console do Rails:

> u = UserAccount.first
  UserAccount Load (0.2ms)  SELECT "user_accounts".* FROM "user_accounts" LIMIT 1
 => #<UserAccount id: 1, person_id: 1, username: "jsilva", password: "abc123", created_at: "2012-08-05 04:02:34", updated_at: "2012-08-05 04:02:34"> 


> u.update_attributes permissions_attributes: [ { restricted_area: :admin, grants: "Read-Write" }, { restricted_area: :backup, grants: "Read-Only" } ]
   (0.3ms)  begin transaction
  Person Load (0.3ms)  SELECT "people".* FROM "people" WHERE "people"."id" = 1 LIMIT 1
  UserAccount Load (0.2ms)  SELECT "user_accounts".* FROM "user_accounts" WHERE "user_accounts"."id" = 1 LIMIT 1
  UserAccount Load (0.1ms)  SELECT "user_accounts".* FROM "user_accounts" WHERE "user_accounts"."id" = 1 LIMIT 1
  SQL (12.6ms)  INSERT INTO "permissions" ("created_at", "restricted_area", "updated_at", "user_account_id") VALUES (?, ?, ?, ?)  [["created_at", Sun, 05 Aug 2012 04:54:31 UTC +00:00], ["grants", "Read-Write"], ["restricted_area", :admin], ["updated_at", Sun, 05 Aug 2012 04:54:31 UTC +00:00], ["user_account_id", 1]]
  SQL (0.2ms)  INSERT INTO "permissions" ("created_at", "restricted_area", "updated_at", "user_account_id") VALUES (?, ?, ?, ?)  [["created_at", Sun, 05 Aug 2012 04:54:31 UTC +00:00], ["grants", "Read-Only"], ["restricted_area", :backup], ["updated_at", Sun, 05 Aug 2012 04:54:31 UTC +00:00], ["user_account_id", 1]]
   (58.7ms)  commit transaction


No exemplo acima, permissões foram adicionadas a uma conta existente de usuário. É possível ir além: todos os dados de UserAccount e Permission podem ser diretamente manipulados um nível acima, numa chamada de Person:

p = Person.create name: "João Oliveira", user_account_attributes: { username: "joliv", password: "secret", permissions_attributes: [ { restricted_area: "admin", grants: "Read-Write" }, { restricted_area: "backups", grants: "Read-Only" } ] }
   (0.1ms)  begin transaction
   (0.0ms)  commit transaction
   (0.1ms)  begin transaction
  SQL (36.8ms)  INSERT INTO "people" ("created_at", "name", "updated_at") VALUES (?, ?, ?)  [["created_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["name", "João Oliveira"], ["updated_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00]]
  SQL (0.6ms)  INSERT INTO "user_accounts" ("created_at", "password", "person_id", "updated_at", "username") VALUES (?, ?, ?, ?, ?)  [["created_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["password", "secret"], ["person_id", 3], ["updated_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["username", "joliv"]]
  SQL (0.4ms)  INSERT INTO "permissions" ("created_at", "grants", "restricted_area", "updated_at", "user_account_id") VALUES (?, ?, ?, ?)  [["created_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["grants", "Read-Write"], ["restricted_area", "admin"], ["updated_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["user_account_id", 3]]
  SQL (0.2ms)  INSERT INTO "permissions" ("created_at", "grants", "restricted_area", "updated_at", "user_account_id") VALUES (?, ?, ?, ?)  [["created_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["grants", "Read-Only"], ["restricted_area", "backups"], ["updated_at", Sun, 05 Aug 2012 05:08:31 UTC +00:00], ["user_account_id", 3]]
   (71.4ms)  commit transaction

Aprecie o poder deste recurso: uma simples linha de comando, e numa única transação são persistidos 4 objetos: Person, UserAccount e duas Permission. Não pára por aí. Este poder é ainda mais amplo, visto que Rails fornece helpers para construção de formulários com nested models - tema que será abordado na parte 3 desta série.

Referências

quarta-feira, 1 de agosto de 2012

Um formulário, multiplos modelos: a praticidade dos MultiModel Forms

MultiModel forms são um poderoso recurso oferecido pelo Rails desde a versão 2.3 - porém desconhecido de muitos programadores. Com eles, é possível editar complexas hierarquias de objetos numa única view. É uma situação que nos deparamos com bastante freqüência:
  • Editar Carrinho de Compras e Itens do Carrinho
  • Dados de uma Pessoa e Informações de Contato
  • Dados de um Usuário e Permissões.
  • Post num blog e suas Tags.
e por aí vai. Este post é o primeiro de uma série de quatro artigos, para ilustrar a utilização destes recursos:
O código desta aplicação de exemplo está disponível neste repositório Github.

Nested Models - One-to-One

Segue o modelo utilizado neste tutorial:
  • Person has one UserAccount
  • UserAccount has many Permissions (parte 2)
Em nome da simplicidade, Person será criado via scaffolding:

rails g scaffold Person name:string

Neste ponto, pode-se rodar as migrations e iniciar o servidor de desenvolvimento:

rake db:migrate
rails s

E já estará disponível a tela - bastante rudimentar - para a edição de Person:
Como queremos editar UserAccount a partir do model Person, dispensaremos scaffold, sendo necessário criar o respectivo modelo:

rails g model UserAccount person_id:integer username:string password:string

rake db:migrate


Por fim, resta configurar as validações e relacionamentos nos respectivos models.

Nested One-to-One

A relação entre os modelos Person e UserAccount é de um-para-um, sendo que UserAccount possui a chave estrangeira person_id (lado belongs_to):

class Person < ActiveRecord::Base
  attr_accessible :name

  validates_presence_of :name
  has_one :user_account
end


class UserAccount < ActiveRecord::Base
  attr_accessible :password, :username

  validates_presence_of :username, :password
  belongs_to :person
end


Podemos usar o rails console para um teste inicial:

$ rails c
> p = Person.create name: "José da Silva"

(0.1ms) begin transaction
SQL (16.4ms) INSERT INTO "people" ("created_at", "name", "updated_at") VALUES (?, ?, ?) [["created_at", Tue, 31 Jul 2012 05:57:41 UTC +00:00], ["name", "José da Silva"], ["updated_at", Tue, 31 Jul 2012 05:57:41 UTC +00:00]]
(59.6ms) commit transaction


No exemplo acima, foi criado um objeto Person, passando para o método create um hash contendo apenas o atributo name.

O uso de nested models possibilita que a chamada create receba também os atributos username e password, para criar uma UserAccount simultaneamente ao objeto Person.

class Person < ActiveRecord::Base
  attr_accessible :name, :user_account_attributes
  validates_presence_of :name

  has_one :user_account
  accepts_nested_attributes_for :user_account
end


Note que é necessário tornar esses atributos acessíveis via mass-assignment, na lista attr_accessible.

> p = Person.create name: "José da Silva", user_account_attributes: { username: "jsilva", password: "abc123" }

(0.1ms) begin transaction
(0.1ms) commit transaction
(0.0ms) begin transaction
SQL (6.1ms) INSERT INTO "people" ("created_at", "name", "updated_at") VALUES (?, ?, ?) [["created_at", Tue, 31 Jul 2012 06:23:26 UTC +00:00], ["name", "José da Silva"], ["updated_at", Tue, 31 Jul 2012 06:23:26 UTC +00:00]]
SQL (0.4ms) INSERT INTO "user_accounts" ("created_at", "password", "person_id", "updated_at", "username") VALUES (?, ?, ?, ?, ?) [["created_at", Tue, 31 Jul 2012 06:23:26 UTC +00:00], ["password", "abc123"], ["person_id", 5], ["updated_at", Tue, 31 Jul 2012 06:23:26 UTC +00:00], ["username", "jsilva"]]
(56.6ms) commit transaction


Validação

O leitor mais atento pode ter notado que UserAccount não está validando a presença de Person. Isto deixa uma brecha no código, por permitir a criação de uma UserAccount desassociada de uma pessoa:

> UserAccount.create username: "joao", password: "abc123"

(0.2ms) begin transaction
SQL (1.4ms) INSERT INTO "user_accounts" ("created_at", "password", "person_id", "updated_at", "username") VALUES (?, ?, ?, ?, ?) [["created_at", Tue, 31 Jul 2012 06:25:34 UTC +00:00], ["password", "abc123"], ["person_id", nil], ["updated_at", Tue, 31 Jul 2012 06:25:34 UTC +00:00], ["username", "joao"]]
(33.3ms) commit transaction


Porém isto não faz sentido no nosso modelo. Façamos a correção:

class UserAccount < ActiveRecord::Base
  attr_accessible :password, :username

  validates_presence_of :person, :username, :password
  belongs_to :person
end


Agora UserAccount passa se comportar conforme esperado:

> u = UserAccount.create username: "a", password: "b"

(0.2ms) begin transaction
(0.1ms) rollback transaction

> u.errors.messages
=> {:person=>["can't be blank"]}


Porém, isto tem um efeito colateral: ela afeta a criação da user_account via nested attributes de Person:

> p = Person.create name: "José da Silva", user_account_attributes: { username: "jsilva", password: "abc123" }
(0.1ms) begin transaction
(0.1ms) commit transaction
(0.1ms) begin transaction
(0.1ms) rollback transaction
> p.errors.messages
=> {:"user_account.person"=>["can't be blank"]}


Para evitar que ocorra a validação quando são usados nested attributes, deve-se informar para Person não validar o atributo person da associação user_account:

class Person < ActiveRecord::Base
  attr_accessible :name, :user_account_attributes
  validates_presence_of :name

  has_one :user_account, inverse_of: :person
  accepts_nested_attributes_for :user_account
end


Update

Para uma operação de atualização, é necessário passar em user_account_attributes o id da user_account previamente criada:

> p.update_attributes user_account_attributes: { id:6, username: "jsilva11", password: "123456" }
(0.1ms) begin transaction
(0.6ms) UPDATE "user_accounts" SET "username" = 'jsilva11', "updated_at" = '2012-07-31 07:43:20.649645' WHERE "user_accounts"."id" = 6
(49.9ms) commit transaction

CUIDADO: caso o id fosse omitido, seria feito um novo insert na tabela user_accounts, e o objeto Person seria reassociado à nova user_account.

Destroy

Para completar este tutorial, suponhamos que faça sentido remover uma user_account, sem remover os respectivos dados de person. Isto pode ser obtido marcando o nested_model com allow_destroy:

class Person < ActiveRecord::Base
  attr_accessible :name, :user_account_attributes

  validates_presence_of :name
  has_one :user_account, inverse_of: :person

  accepts_nested_attributes_for :user_account, allow_destroy: true
end


Agora, pode-se remover user_account passando _destroy: true no hash user_account_attributes:

> p.update_attributes user_account_attributes: { id:6, _destroy: true }
(0.2ms) begin transaction
UserAccount Load (0.1ms) SELECT "user_accounts".* FROM "user_accounts" WHERE "user_accounts"."person_id" = 7 LIMIT 1
SQL (4.9ms) DELETE FROM "user_accounts" WHERE "user_accounts"."id" = ? [["id", 6]]
(47.8ms) commit transaction

> p.reload.user_account
Person Load (0.3ms) SELECT "people".* FROM "people" WHERE "people"."id" = ? LIMIT 1 [["id", 7]]
UserAccount Load (1.9ms) SELECT "user_accounts".* FROM "user_accounts" WHERE "user_accounts"."person_id" = 7 LIMIT 1
=> nil

Referências

domingo, 13 de novembro de 2011

Deploy de aplicações Rails e Django no Heroku

No post anterior foi mostrada a importância de se colocar o projeto num servidor de controle de versões, mesmo logo após a sua criação. Algumas preocupações puderam ser rapidamente testadas e solucionadas, por exemplo o setup em máquinas de outros desenvolvedores.

Ainda nesta fase tão precoce, podemos ir mais além: testar o deploy da aplicação num ambiente production-like. Desta forma, cria-se uma cultura de, em cada iteração, testar de ponta-a-ponta o processo de desenvolvimento.

Um dos objetivos é antecipar questões e riscos que tradicionalmente só seriam atacados ao final do projeto. Caso surjam problemas de integração, ou dificuldades técnicas que possam colocar em risco a subida do sistema para produção, as causas podem ser prontamente diagnosticadas e tratadas o mais cedo possível antes que possam comprometer o sucesso do projeto.

Setup do Heroku

O Heroku é uma opção muito popular para o deploy de aplicações Rails, que consiste simplesmente em executar:

git push heroku master

ou seja, pushando o projeto para um repositório Git remoto no Heroku.

A preparação é semelhante a da criação de uma conta no Github. É necessário criar uma conta no Heroku, e fazer o upload de uma chave pública para administração da conta via terminal.

Instalação

O primeiro passo é instalar a gem do heroku:

gem install heroku

Chave pública

Em seguida, fazer o upload da chave pública:

Caso o heroku não encontre uma chave pública em ~/.ssh/id_rsa.pub, e também não exista a chave privada ~/.ssh/id_rsa correspondente, o próprio heroku é capaz de gerar estas chaves para nós (como mostrado no trecho acima).

Podemos também aproveitar a chave pública do github, bastando que ela esteja presente em ~/.ssh/id_rsa.pub para ser upada para o heroku.

Caso mais de uma chave esteja presente no diretório .ssh, o heroku pergunta qual deve ser usada:

Criação da aplicação no Heroku

Resolvida a questão das chaves, podemos criar a aplicação no heroku: Este comando cria um ambiente no Heroku e o adiciona automaticamente como um repositório Git remoto do projeto, o que pode ser confirmado: Note também que, após deployada, a aplicação responderá inicialmente no endereço http://afternoon-robot-3025.heroku.com.

Deploy de uma aplicação Rails no Heroku

Dispensa comentários:

Até mesmo para abrir o navegador, o heroku ajuda:

heroku open

Rackfile e Procfile

O Heroku consegue fazer o deploy de aplicações Rails devido à presença do arquivo config.ru na raiz do projeto. Trata-se de um arquivo Rack, que instrui ao Heroku a forma como a aplicação é iniciada:

Procfile e Foreman

Uma alternativa ao Rack é criar um arquivo Procfile na raiz do projeto. Trata-se de um mecanismo de declarar quais comandos devem ser executados ao deployar na plataforma Heroku. Ele consiste de um conjunto de pares informando o tipo de processo e o comando para executar um determinado processo: Apesar de opcional em aplicações Rails, seu uso é recomendado pois proporciona maior controle e flexibilidade para a aplicação. Além disso, o Heroku provê o comando

heroku scale

para ajustar como escalar a aplicação, baseados no Procfile.

Para executar localmente aplicações baseadas no Procfile, é necessário instalar o Foreman.

gem install foreman

Ao iniciar a aplicação com o foreman, ele inicia cada um dos processos declarados no Procfile:

Django e Heroku

Conforme anunciado neste post, o Heroku também oferece suporte a Python, no stack* Cedar, baseado no Ubuntu 10.04.
* o Heroku oferece diferentes stacks - ambientes completos de deploy, incluindo o sistema operacional e bibliotecas associadas.

Para criar um ambiente no stack cedar, é necessário executar o comando:

heroku create --stack cedar

e o deploy também é feito via git push:

Porém, como se vê acima, o push é rejeitado, informando que o Heroku não consegue detectar nenhuma aplicação Rails/Rack. Alguns ajustes são necessários para conseguir realizar o deploy da aplicação Django no Heroku.

Procfile para rodar aplicações Django no Heroku

Aplicações que NÃO são baseadas no Rack podem ser deployadas no Heroku usando o Procfile. No caso de uma aplicação Django, basta criar um Procfile com o seguinte conteúdo:

web: python manage.py runserver

que a aplicação passa a ser inicializável via foreman:

Agora que está tudo rodando localmente, basta apenas fazer o deploy e correr pro abraço, vai dar até pra sair mais cedo e pegar um cineminha: Oooops... Agora, através do Procfile, o Heroku já é capaz de reconhecer que se trata de uma aplicação Python, porém continua rejeitando o deploy, com uma enigmática mensagem "Django app must be in a subdirectory".

Ainda bem que o Google e o Stack Overflow existem, e alguém já havia postado a solução para este problema: http://stackoverflow.com/questions/7974902/deploying-existing-django-app-on-heroku.

Para deployar a aplicação Django no Heroku, ela precisa estar organizada de tal forma que o Procfile e o requirements.txt fiquem na raiz do repositório, e o projeto Django deve ser um subdiretório a partir da raiz do repositório.

Com esta nova organização, é importante assegurar que o arquivo settings.py esteja com o valor correto para a propriedade ROOT_URLCONF:

ROOT_URLCONF = 'urls'

Ajustada a estrutura do projeto, aí sim, esperamos que o deploy seja bem sucedido.

Basta agora um heroku open e ver se o navegador abre a página e... Ooops. Nada acontece:

A essas alturas, cineminha já era... Neste caso, nem com ajuda de Google e Stack Overflow surgiu alguma pista. Recorrendo ao comando

heroku logs

é possível visualizar o log da subida da aplicação no Heroku, tentando procurar alguma pista sobre o que está faltando: Voilá, nos logs surge a pista: a aplicação crasheou durante a subida, devido à ausência do módulo psycopg2.

Googleando um pouco mais, surge este blog, com instruções simples para instalar localmente este módulo:

  • Pré-requisito:
    sudo apt-get install libpq-dev python-dev
  • Instalação: adicionar ao requirements.txt a linha
    psycopg2==2.4.2
  • Executar
    pip install -r requirements.txt

Após nova subida, é cruzar os dedos e... nada! Eis o novo log:

Ao que o erro indica, o Heroku não faz o binding na porta 8000, e sugere pesquisar a variável de ambiente PORT. Um tanto enigmático. Recorrendo mais uma vez ao Google, eis uma pista melhor, nos comentários deste blog:

"Creating a Procfile and adding: "web: play run --http.port=$PORT $PLAY_OPTS" fixed the problem." (Ivar Abrahamsen)


o que nos conduz a alterar o Procfile para:

web: python manage.py runserver 0.0.0.0:$PORT

E finalmente:

Deploy de aplicação Django no Heroku - Resumo

  1. O projeto Django deve ser um subdiretório a partir da raiz que é comitada no Git
  2. Alterar o settings.py, fazendo
    ROOT_URLCONF = 'url'
  3. Adicionar um Procfile na raiz do projeto contendo:
    web: python manage.py runserver 0.0.0.0:$PORT
  4. Instalar o psycopg2
    1. Para deployar no Heroku é suficiente adicionar ao requirements.txt:
      psycopg2==2.4.2
    2. Para instalar localmente, é necessário:
      1. Instalar pré-requisitos
        sudo apt-get install libpq-dev python-dev
      2. Invocar o PIP pra instalar o pycopg2
        pip install -r requirements.txt
  5. Deploy: git push heroku master

Considerações Finais

As tentativas que envidamos para conseguir subir a aplicação Django no Heroku reforçam a tese da importância de testar o processo de desenvolvimento de ponta-a-ponta. Em cada iteração, é importante incluir o deploy para um ambiente production-like, para identificar dificuldades e riscos iterativamente, à medida que a aplicação é desenvolvida.

quarta-feira, 9 de novembro de 2011

Colaboração em projetos Rails e Django usando o Github

Nos posts anteriores, foi mostrada a criação de projetos Rails e Django, e explicado o uso do Bundler e do PIP para gerenciamento de dependências do projeto. Foi mostrado também como iniciar servidores web com os comandos

rails s

e

python manage.py runserver,

nos projetos recém criados, bem como os utilitários para acesso rápido a banco de dados

rails db

e

python manage.py dbshell.

Já temos material suficiente para iniciar um repositório Git, compartilhar no Github, e o mais importante: testar o workflow de colaboração em diferentes máquinas. Este passo é muito importante, para verificar se o setup inicial do projeto está suficientemente simples e documentado, permitindo que outros colaboradores, sem dor de cabeça, possam baixar e configurar o projeto em suas máquinas.

Adicionando o projeto Rails no Github

Clonando o projeto

Na listagem acima, o projeto é clonado do github através do comando

git clone

Em seguida, o diretório do projeto recém clonado é listado. Porém, a despeito da presença do arquivo .rvmrc na raiz do projeto, nada acontece ao entrar no diretório, sendo que era esperado que o RVM carregasse o ambiente Ruby do projeto.

Neste post foi mostrado que o .rvmrc pode ser usado para executar um script

rvm use 1.9.2@ambiente_app_contatos

para carregar o ambiente ruby ao entrar no diretório.

Nesta nova máquina, porém, o RVM ainda não está instalado, portanto, os scripts do arquivo .rvmrc não foram executados. O projeto tem, portanto, um pré-requisito de configuração de ambiente após ser clonado: instalar o RVM e o Ruby 1.9.2.

Graças a este simples teste, foi possível detectar o mais cedo possível a necessidade de documentar este fato.

O arquivo README

Neste ponto, a opção mais simples é documentar este pré-requisito, criando um arquivo README. Tudo bem, tudo bem, muitos de nós desenvolvedores nem sempre dá a atenção devida a este tipo de documentação tão primária. Porém isso não nos exime de escrevê-la, com pelo menos as informações gerais do projeto e as instruções de setup para que ele seja facilmente configurado e executado ṕor qualquer desenvolvedor.

Um ponto para o Github: o README é mostrado na página principal do projeto, o que melhora bastante sua exposição e aumenta a probabilidade de ele ser lido por novos desenvolvedores ao baixar o projeto.

Vale notar também que este arquivo pode ser escrito usando linguagens de marcação como o markdown e o textile, melhorando ainda mais a sua apresentação e legibilidade.

Colocada a importância de fornecer um arquivo README, visite a página inicial do projeto e avalie você mesmo o quanto essas instruções podem ser úteis ao clonar um projeto.

Documentação executável

Um fato interessante que comumente ocorre ao escrever um README é perceber que vários passos de setup inicial podem ser facilmente automatizados em arquivos de script. Foi exatamente o que aconteceu enquanto documentei o setup deste projeto: o README deu origem ao arquivo setup-project, que pode ser executado com o comando:

source ~/App-Contatos-Rails/setup-project

Ao final, este exercício de documentação levou também o benefício da automatização :-)

Adicionando o projeto Django no Github

Clonando o projeto

Similarmente como ocorreu ao clonar o projeto Rails em uma outra máquina (que não tinha o RVM instalado), ao entrar no diretório do projeto, não ocorreu o carregamento automático do VirtualEnv configurado no arquivo .rvmrc.

As instruções de setup - para instalação do RVM e do VirtualEnv - também foram documentadas num README, cujas instruções foram facilmente aproveitadas para a criação de um script setup-project:

O arquivo .gitignore em projetos Django

À medida que vamos trabalhando na aplicação, são gerados alguns arquivos que não precisamos versionar no Git. Por exemplo, os arquivos compilados do python (*.pyc) e o arquivo do banco de dados sqlite local. Para evitar que estes arquivos sejam submetidos para o Git, podemos adicionar um arquivo .gitignore ao projeto:

Nota: Em aplicações Rails, este arquivo é gerado junto com a criação da aplicação. Isso pode ser notado na listagem do início deste post que mostra o commit inicial do projeto, com o arquivo .gitignore já presente.

Apesar de esta versão inicial estar bem simples, novas adições podem ser feitas todas as vezes que se perceber que um diretório ou um padrão de arquivos não precisa ser controlado pelo Git.

Procurando no Google por palavras chave [Django .gitignore] são listados vários exemplos de arquivos .gitignore mais abrangentes - para este post, prefiro manter as coisas simples.

Caso já tenha comitado arquivos indesejados para o Git, além de adicionar o padrão no arquivo .gitignore, é necessário também remover os arquivos comitados - nada que não poassa ser resolvido com o git rm.

Considerações Finais

Ao iniciar um projeto, é muito importante colocá-lo o mais cedo possível num repositório de controle de versão. São inúmeros os benefícios: backup, versionamento desde as primeiras versões, compartilhamento, e geração da documentação mínima necessária para que o projeto seja facilmente configurável e acessível para outros desenvolvedores, pra citar alguns.

terça-feira, 8 de novembro de 2011

Gerenciamento de Dependências com Bundler e PIP

No post anterior, foi mostrado como criar novos projetos em Rails e Django. Neste estágio inicial de projeto, algumas preocupações começam a surgir: que bibliotecas usar no projeto? Como irei baixar e instalar essas bibliotecas? Meus colegas de time conseguirão baixar o projeto de um repositório e configurar facilmente seus ambientes com as bibliotecas selecionadas?

Neste momento, fica muito evidente o poder do RVM e do VirtualEnv, e seus companheiros Bundler e PIP.

Em Rails, as dependências são configuradas no arquivo Gemfile, gerado automaticamente na raiz do projeto quando ele é criado. Em Django, um arquivo de configuração de dependências pode ser gerado através do comando pip freeze.

Bundler e o arquivo Gemfile

Um projeto Rails 3.1 é criado inicialmente com as seguintes dependências:

Note que as versões requeridas de cada dependência são especificadas. Isto é importante para evitar que a aplicação deixe de funcionar devido à atualização de alguma das bibliotecas das quais ela depende.

Neste caso, foi declarada uma dependência exata ao Rails na versão 3.1.1. Para o uglifier, a aplicação exige no mínimo (>=) a versão 1.0.3. Para o sass-rails e para o cofee-rails, são exigidas no mínimo as versões 3.1.4 e 3.1.1, respectivamente. O operador (~>) tem um significado especial: para o sass, ele denota "qualquer versão 3.1.X maior que 3.1.4, ou posto de outra forma, maior ou igual a 3.1.4 e menor que 3.2".

Outro ponto a ser notado é que, além das versões, o Gemfile permite também o agrupamento de dependências. no trecho acima, o sass-rails, o coffee-rails e o uglifier foram colocados no grupo :assets. Outro grupo bastante comum é o :tests. Por exemplo, num projeto usando cucumber, teríamos:

Através do Gemfile, também é possível adicionar uma dependência direta ao repositório de código de uma biblioteca - desta forma, o projeto estará sempre usando o "latest build", o "nightly snapshot" dessas dependências.

Agora que já conhecemos o Gemfile, resta dizer que a instalação das dependências é simples quanto executar na linha de comando:

Este comando oferece também a opção de filtrar grupos de pacotes para não serem instalados:

PIP e o arquivo requirements.txt

Apesar de o django não gerar automaticamente um arquivo de dependências quando o projeto é criado - muito provavelmente para não amarrar o desenvolvedor ao uso do PIP - podemos usar o comando pip freeze para ter benefícios semelhantes aos proporcionados pelo Gemfile no Rails. Execute na raiz no projeto django:

E um arquivo com o seguinte conteúdo será gerado:

O nome requirements.txt não é obrigatório, mas é comumente usado. Assim como o Gemfile, pode-se especificar quais as versões são requeridas para cada dependência, porém a sintaxe é bem diferente.

Possui apenas os operadores ==, >=, >, <=, <. Para funcionalidade similar ao ~, permite combinar operadores, por exemplo: Django>=1.3,<1.4.

Também permite configurar as dependências para serem baixadas diretamente de repositórios, usando o operador -e (de "editable"):

Mais detalhes sobre como usar o -e com Mercurial, Bazar, etc em http://www.pip-installer.org/en/latest/requirement-format.html.

Diferente do Gemfile, o requirements.txt não fornece a opção de criar grupos. Para este comportamento, costuma-se agrupar as dependências em diferentes arquivos, por exemplo, um arquivo test-requirements.txt para testes. Dada esta filosofia, existe a opção de incluir arquivos dentro de outros, através do -r

Agora que já conhecemos o requirements.txt, podemos executar o comando pip install -r para instalar as dependências do projeto:

Considerações Finais

Com o Bundler e o PIP conseguimos resolver parte do problema: gerenciar as dependências do projeto. No próximo post, será simulado um segundo e grande benefício: a facilitação do setup do projeto em outras máquinas, por exemplo, entre os vários integrantes do time.

domingo, 6 de novembro de 2011

Começando aplicações Rails versus Django

No post anterior, foi mostrado como criar ambientes de desenvolvimento Rails e Django, comparando o RVM (Ruby Version Manager) com o PIP (Python Install Packages).

Este artigo dá um pequeno passo adiante, mostrando as similaridades e diferenças durante a criação aplicações usando estes dois frameworks web.

Não se preocupe se não leu o artigo anterior, este post mostrará todos os passos necessários para criar as aplicações em Rails e em Django

Criação do Projeto Rails

Instalar RVM:

Desta forma, o RVM é instalado no diretório ~/.rvm, como pode ser notado abaixo:

É necessário configurar o PATH adicionando a seguinte linha no ~/.bash_profile.

Para atualizar o PATH, pode-se simplesmente abrir um novo terminal, ou executar
source ~/.bash_profile

Instalar o Ruby (instale a versão que for aplicável ao seu projeto).

Criar um ambiente "ambiente_app_contatos" baseado no Ruby 1.9.2

Uma forma de saber quais ambientes estão disponíveis para usar com o RVM é listar o conteúdo do diretório ~/.rvm/gems:

O RVM possui também vários comandos utilitários. Por exemplo, para saber qual ambiente está atualmente em uso:

Instalar Rails

Criar a aplicação de Contatos.

O argumento -T serve para pular a criação dos testes de unidade. Existem várias frameworks de teste que podem ser usadas com o Rails (UnitTest, RSpec, Cucumber, etc...), elas podem ser adicionadas no projeto num momento posterior.

Veja a estrutura do projeto criado pelo Rails:

Criar um arquivo .rvmrc para carregar o ambiente correto quando navegar para o diretório da aplicação

O comando acima cria um arquivo .rvmrc no diretório do projeto. Ao entrar no diretório (por exemplo cd /path/to/app_contatos_rails), o ambiente correto é carregado:

Uma vez criado o projeto, é possível executar comandos rails de dentro do diretório da aplicação, por exemplo:

  • rails console ou rails c, para iniciar o interpretador de comandos;
  • rails server ou rails s para iniciar o servidor web;
  • rails dbconsole ou rails db para iniciar o console do banco de dados (por padrão o SQLite).

Criação de um projeto Django

A primeira diferença que vamos ao trabalhar com Django em relação ao Rails é que, enquanto o Ruby poderia ser instalado usando o próprio RVM, a instalação do Python deve ser feita sem contar com a ajuda do gerenciador de pacotes VirtualEnv.

O VirtualEnv nada mais é que um arquivo virtualenv.py, que deve ser executado por um interpretador Python previamente instalado. Como normalmente as distribuições Linux já vêm com o Python, este fato acaba sendo transparente, mas pode-se rodar o apt-get (ou yum, ou rpm) para verificar a versão instalada ou mesmo atualizar para uma versão mais recente:

Não é obrigatório, mas para fins de melhor organização, a criação de ambientes python será feita dentro de um diretório .virtualenv

Como se pode ver, o virtualenv cria uma instalação python no diretório ambiente_app_contatos, contendo apenas o pip e o easy_install, que serão usados para gerenciar a instalação de novos pacotes.

Para ativar este ambiente, é necessário carregar o arquivo bin/activate

Note que o terminal passa a indicar qual ambiente python está atualmente ativado! Chega a hora de instalar o Django, usando o pip:

E com o Django instalado, vamos criar a aplicação. Enquanto no Rails a aplicação é criada em um único comando (rails new) - criando toda a estrutura para rodar um webserver e acessar um banco de dados, juntamente com a estrutura da aplicação - em Django, isto ocorre em duas etapas:

1) python django-admin.py startproject

Ao criar o projeto são gerados os arquivos manage.py, settings.py e urls.py. Com esta estrutura mínima, já é possível executar alguns comandos, por exemplo, para iniciar um webserver (python manage.py runserver) ou acessar um banco de dados (python manage.py dbshell).

Para acessar um banco de dados, antes é necessário completar a configuração no arquivo settings.py. No trecho abaixo, foi ajustada uma configuração para sqlite, persistindo dados num arquivo contatos.sqlite.

Com a configuração ajustada, basta executar python manage.py dbshell para iniciar uma sessão com o banco de dados.

2) python manage.py startapp

Por fim, após a criação do projeto, podemos proceder com a criação da aplicação

Como se vê, a estrutura inicial de uma aplicação Django é bem mais simples que a de uma aplicação Rails, contendo apenas 3 arquivos relevantes - models.py, tests.py e views.py.

No Django, não existe similar ao arquivo .rvmrc (vimos na primeira parte deste post que a presença deste arquivo no diretório da aplicação rails permite o carregamento automático do ambiente ruby adequado). Portanto, ao iniciar uma nova sessão de terminal, será necessário ativar novamente o ambiente. Isto pode se tornar um inconveniente.

Um artifício engenhoso pode ser tirar vantagem pelo fato de o rvm estar instalado, e criar um arquivo .rvmrc no diretório do projeto django, contendo o comando para ativação do ambiente virtualenv.

Veja como esta "malandragem" funciona bem:

Conclusão

Através deste artigo, busquei apontar que, apesar de serem grandes as diferenças entre projetos Rails e Django, existem muitas funcionalidades e formas de trabalho comuns, que justificam aprender os frameworks em paralelo.

Ambos os frameworks oferecem facilidades para rodar interpretadores de comandos Ruby/Python; para iniciar websersers; e para iniciar sessões com o banco de dados, via terminal - tarefas que fazem parte da rotina do desenvolvimento de uma aplicação web.

As diferenças começaram a ficar bastante evidentes. A anatomia de uma aplicação Rails, por exemplo, é relativamente complexa: em um único comando (rails new) é criada toda a infra-estrutura de suporte do projeto (para rodar o webserver e o banco de dados), juntamente com a estrutura da própria aplicação. Em Django, isto é feito em duas etapas - e ainda assim, a quantidade de artefatos gerados pelo Django é bem menor.

Não é minha intenção afirmar que uma abordagem é melhor que a outra - são apenas diferentes, e essas diferenças serão abordadas em futuros posts.

No próximo post, avançaremos mais um passo, mostrando os arquivos Gemfile, usado no Rails em conjunto com o Bundler; e o arquivo requirements, usado em conjunto com o PIP no Django; ambos para gerenciamento das dependências da aplicação.

Ainda no roadmap próximo, será mostrado como criar models, e como utilizar migrations para versionar a evolução do schema de banco de dados em ambos os frameworks.

sábado, 5 de novembro de 2011

RVM e VirtualEnv

Em Ruby uma das primeiras coisas que se aprende é a instalar novos pacotes através do RubyGems:

Em Python, o gerenciamento de pacotes (eggs) era feito tradicionalmente com o easy_install, mas que sendo substituído pelo PIP.

Mesmo com tamanha facilidade para instalar e gerenciar pacotes que ambas as linguagens oferecem, existirão casos onde será necessário trabalhar simultaneamente com conjuntos distintos de gems / eggs - por exemplo ao trabalhar em projetos que possuem conjuntos distintos de pacotes, ou testar o upgrade de pacotes de um determinado o projeto.

RVM - Ruby Version Manager

Em Ruby, a criação de ambientes independentes pode ser feita com o RVM. A própria instalação do Ruby pode ser feita usando o RVM. Veja como é simples:

Pré-requisitos

Se estiver no Ubuntu, é necessário instalar os seguintes pacotes adicionais

  • Baixe o RVM:
  • A instalação modifica o .bashrc, alterando o PATH do terminal:
  • É necessário iniciar um novo terminal para a alteração no PATH fazer efeito.

Instalado o RVM, podemos finalmente instalar multiplas versões do Ruby.

Para criar gemsets com diferentes versões do Ruby:

Para saber quais ambientes foram criados através do RVM, basta listar o diretório HOME/.rvm/gems ($ ls ~/.rvm/gems)

Para usar um gemset específico

VirtualEnv

Em Python, o virtualenv desempenha um papel semelhante. Porém, diferente do RVM, capaz de gerenciar a própria instalação do Ruby em múltiplas versões, o virtualenv foca apenas no gerenciamento de pacotes - não se preocupando com a instalação do Python.

A forma mais simples de usar o virtualenv é baixando o arquivo virtualenv.py no diretório home:

E executando-o com o python previamente instalado:

O que o virtual_env faz é criar uma nova instalação do python no diretório meu_ambiente_1. O argumento --no-site-packages serve para que o virtualenv ignore completamente quaisquer pacotes que tenham sido instalados globalmente em /usr/lib/pythonX.X/site-packages, tornando o ambiente totalmente novo e independente.

Para usar este ambiente, é necessário ativá-lo:

O prompt de comando passa a indicar qual ambiente está sendo usado:

Daí é só usar normalmente o pip para instalar os pacotes necessários.

A instalação ocorre toda nos respectivos diretórios meu_ambiente_1/bin e meu_ambiente_1/lib/pythonX.X/site-packages, não impactando na instalação global do python (/usr/lib/pythonX.X), permitindo uma separação completa entre diferentes ambientes.

Conclusão

Espero que a abordagem proposta neste artigo - mostrando similaridades e diferenças entre características dessas duas poderosas linguagens e frameworks (Ruby/Rails e Python/Django) - seja uma forma didática de aprender e apreciar os recursos que elas oferecem, proporcionando um aprendizado poliglota prático e divertido.

Carreira Poliglota

Em 2011, as experiências de trabalho na Concrete Solutions e na Globo.com têm sido um grande incentivo para buscar uma carreira poliglota. Apesar de ainda trabalhar boa parte do tempo com Java, já pude passear por vários mundos:
  • Ainda em Java, finalmente conheci o Maven (indispensável), Spring3 (muito bom!) e o ActiveMQ.
  • Objective-C e Android: desenvolvimento mobile é desafiador e divertido!
  • PHP, WordPress, WP-Commerce: desfiz um antigo preconceito, e passei a respeitar PHP! (ainda preciso conhecer o Magento).
  • JavaScript: em pensar que há alguns anos se dizia que "JavaScript não é linguagem" - é possível até mesmo fazer TDD e Integração Contínua! Alguns caminhos interessantes: Knockout.js, Flot.js, qUnit, Jasmine, Mootools.

Mas o que me motivou a escrever este post foi o desafio de aprender duas grandes frameworks web: Django (Python) e Rails (Ruby).

Comecei a estudar Rails através dos videos no Rails For Zombies. Minha admiração por este frame ganhou grandes proporções com o livro Rails Tutorial - o primeiro livro onde já no primeiro capítulo vc é ensinado a colocar o seu projeto num Controle de Versão, incentivado ao TDD, e a fazer deploy tão logo vc tenha um build executável de sua aplicação.

Django é também uma opção poderosa. Para aprender, é obrigatório passar pelo Tutorial Oficial, e sua "quinta parte não oficial", que trata de uma forma bem didática como fazer TDD.

Nos próximos posts tentarei documentar um pouco desse aprendizado de Rails e Django.

quinta-feira, 28 de abril de 2011

Primeiros passos com Objective-C e iOS Development

[Update: excelente material sobre ObjectiveC: http://www.astro.iag.usp.br/~algol/computacao/ObjCtutorial.html. Dá até pra programar usando MinGW no Windows!]

Pois é, cá estou me aventurando com MacBook, Objective-C e iOS, visando aprender a desenvolver aplicações para iPhone. A iniciativa surgiu da necessidade de ter mais independência em um projeto que estou desenvolvendo. Fiz o backend da aplicação, em Java, e agora estou começando a estudar o frontend da aplicação, uma app iPhone.

A primeira dificuldade em que esbarrei foi a sintaxe da linguagem. Ter programado muito em C/C++ durante a graduação (minha Iniciação Científica e meu TCC foram um escrito em C++) me ajudou a não ter medo da sintaxe. Porém Objective-C possui construções bastante diferentes, e o artigo "Learning Objective-C: a Primer"  foi fundamental para dar o primeiro passo, que será seguido de um Hello World para iPhone e de "The Objective-C Programming Language".

Desta primeira leitura, tentando fazer um paralelo entre ObjectiveC e Java (se é que isto é possível):
  • Classes Java (atributos + métodos): Em ObjectiveC, classes são divididas em @interfaces (.h) (declarações de atributos e métodos) e @implementations (.m), onde os métodos são efetivamente implementados.
  • Métodos de Acesso (getters e setters): são declarados como @property na @interface e @synthesize na @implementation.
  • Interfaces Java: no sentido que definem contratos a serem implementados, se assemelham aos Protocolos Objective-C (um .h especial, onde são declarados apenas métodos do protocolo, sem atributos nem propriedades).
  • @end encerra a declaração de classes, interfaces e protocolos.
  • @implementations baseadas em protocolos usam uma declaração semelhante aos generics Java (<Protocolo1, Protocolo2, ...>), mas uma coisa não tem nada - absolutamente nada - a ver com a outra.
  • Modificador de Tipo (-): método de instância; (+): método estático.
  • Assinatura de métodos: achei interessante, parece permitir a criação de fluent interfaces de acordo com os argumentos de um método.
  • Chamadas de métodos: têm uma sintaxe bastante particular, entre colchetes, denominada mensagem.
Por agora, são as primeiras impressões. Claro que a percepção vai mudar muito (ainda estou a caminho de implementar um hello world), e vai ser interessante documentar esse aprendizado.

segunda-feira, 4 de abril de 2011

Agendamento de tarefas com o Spring 3

Com relativa freqüência, nos deparamos com a necessidade de agendar tarefas:
  • De tempos em tempos, executar uma regra de negócio e enviar o resultado para um e-mail.
  • Escanear periodicamente um determinado diretório, para verificar se existem novos arquivos
  • Disparar newsletters
  • etc
A simplicidade de criar tarefas agendadas no Spring 3 impressiona. Basta configurar o namespace <task> e anotar métodos de negócio com @Schedule ou @Async:

beans.xml


Tarefa anotada com @Component e @Scheduled


O @Schedule pode ser usado, passando como argumento uma expressão Cron, em intervalos fixos (fixedRate), ou com um delay entre chamadas (fixedDelay).
OBS: fixedDelay é o tempo entre o término da última execução e o início da próxima execução; fixedRate é o tempo o início de cada execução; portanto o primeiro pode ocorrer em intervalos variáveis.

domingo, 13 de março de 2011

GWT: A longa estrada

Em dezembro de 2009, decidi aprender GWT. Na época, estava interessado nas possibilidades desta escolha: apps mais inteligentes e interativas, menos round-trips no servidor, melhor tempo de resposta, envio de cálculos para serem feitos no lado cliente, deixando para o servidor apenas a responsabilidade de entregar os dados necessários para os cálculos, etc...

Porém o aprendizado não tem sido fácil. Em 2010, a principal referência de como arquitetar uma App GWT era a aprensentação de Ray Ryan, no Google I/O 2009. Ainda assim, os padrões apresentados mais pareciam peças de um quebra-cabeças, que precisavam ser experimentadas para encontrar o melhor encaixe, antes da grande figura se revelar e "cair a ficha" de como se tornar produtivo usando a tal caixinha de ferramentas...

Foi uma excelente experiência, onde extrapolei meus skills de programação, por 5 anos viciados no J2EE old-style modo de desenvolver. Este estudo rendeu frutos:
  • Artigos publicados na Revista MundoJ
    • Mar/2010 - Edição 40: Hello GWT!
    • Mai/2010 - Edição 41: GWT: Uma arquitetura MVP
    • Jan/2011 - Edição 45: GWT 2.1 e o Framework MVP Oficial da Google
    • Mai/2011 - Edição 47: Top Secret ("Aguarde e confie", parodiando o "grande trapalhão"...)
  • Sistemas Desenvolvidos:
Neste momento, estou tentando inserir a API RequestFactory na arquitetura. Já investi umas boas 30 horas tentando... Ela é mais intrusiva que as demais APIs - fornece facilidades tanto na integração com os Widgets, com a framework MVP, ainda que seu principal papel seja melhorar a comunicação cliente-servidor, viabilizando uma arquitetura baseada em DTOs. É uma API que dá um medo de começar a usar "de qualquer jeito", e criar pequenos frankesteins...

Para "piorar", sei que, depois desse aprendizado, ainda terei que investir mais umas boas horas para aprender a usar o GWT Designer e o Spring Roo, que prometem para o desenvolvedor benefícios tanto em usabilidade quanto em produtividade.

A API RequestFactory

De todos os desafios para aprender GWT, de longe o maior enigma está sendo a API Request Factory. Sua documentação é superficial, mostrando apenas como fazer a comunicação cliente-servidor. No release do GWT 2.2, a documentação foi complementada, mostrando como se usar uma abordagem ServiceLayer como alternativa à abordagem ActiveRecord introduzida pelo GWT 2.1. Mas a documentação ainda não ajuda muito a encaixar as peças da API com o restante do quebra-cabeças.

Depois de muito tentar e ainda não se sentir tão seguro com esta API, decidí debulhar a principal fonte de documentação disponível: o código-fonte da aplicação Expenses, distribuída no diretório samples do GWT. Minha expectativa é que, tentando refazer a aplicação, passo-a-passo, consiga finalmente compreender todo o poder e as facilidades que ela oferece.

O código-fonte será disponibilizado em https://github.com/fabiolnm/Expenses-GWT.

Happy GWTting!

segunda-feira, 28 de fevereiro de 2011

Sudoku Solver

Ontém, o amigo Edcana comentou no twitter que estava escrevendo um resolvedor de Sudokus. Sempre gostei desse jogo, mas nunca tinha passado pela cabeça em escrever um programa para resolvê-lo... E foi uma diversão interessante...

E foi uma diversão interessante... Abaixo uma versão parcial da aplicação, escrita em GWT, com 2 estratégias se solução (resolvem os níveis fácil e médio de problemas propostos no iGoogle). Já descobri uma terceira estratégia para resolver o nível hardest, mas ficará para a próxima semana.

O código está disponível em https://github.com/fabiolnm/Sudoku-Solver. A aplicação roda num iframe que mostra a app deployada no AWS (https://s3.amazonaws.com/mind_share/sudoku/index.html).

A primeira solução foi até tranquila... Porém o código mal-desenhado dificultou a adição de novas regras... Antes de conseguir adicionar uma segunda estratégia de solução, foi necessário fazer muitas refatorações no código. E sem testes, a solução de bugs só foi possível graças aos recursos de logging e debugging do plugin GWT para o Eclipse.

Nesta aplicação, me questinei se TDD seria útil... Minha compreensão sobre o problema mudou tanto e tantas vezes, que talvez se estivesse escrevendo testes antes, não teria conseguido avançar na velocidade desejada... Porém, quando precisei refatorar código, as alterações eram penosas. Sempre acrescentava bugs, que demorava para encontrar no debugger.

Entender melhor o domínio, e só depois de um certo ponto adicionar testes, seria um pattern ou anti-pattern? Argumento pró: acelerar tentativas e erros (TDD freia um pouco o processo de aprendizado?). Argumento contra: depois que a funcionalidade está escrita, dá preguiça de escrever teste...

Minha conclusão, depois desse problema, foi: não importa se vc faz testes antes ou depois. Antes de refatorar, escreva testes! O custo e o aborrecimento de quebrar funcionalidades justificam ter testes antes de qualquer modificação significativa do código.

É um bom momento, pois com uma aplicação minima rodando, alguns conceitos já foram provados, e os bad smells começam a ficar evidentes. E como não se quer quebrar nada a partir desse ponto, é uma motivação para começar a escrever testes, e através deles remover os bad smells e pogs inevitavelmente praticados durante a primeira prova de conceito da aplicação.

segunda-feira, 10 de janeiro de 2011

Gerenciamento de Dependências com Maven - Parte 2

Neste post, será mostrada a view "Maven Repositories" do Eclipse, ilustrando algumas tarefas básicas, por exemplo, indexar um repositório para configurar / atualizar a busca de dependências pelo editor pom.xml do Eclipse.

A dinâmica do artigo será simular um projeto que utiliza usando Spring, JMS e ActiveMQ, para um projeto de mensageria. Durante os exercícios são sugeridas algumas dicas para selecionar as dependências corretas para o projeto.

Caso não tenha lido, a parte 1 desta série está disponível neste link.

Happy Maven!


Setup do Projeto - Dependências do Spring

Este exercício mostra como adicionar no projeto a dependência ao Spring Framework, uma poderosa biblioteca de Injeção de Dependências (uma excelente apostila sobre Spring pode ser acessada aqui).
  1. Crie um novo projeto Maven (se precisar de ajuda, leia este post).
  2. Clique no arquivo pom.xml, para abrir o editor do descritor do projeto.
  3. Na aba Dependencies, clique em Dependency / Add...
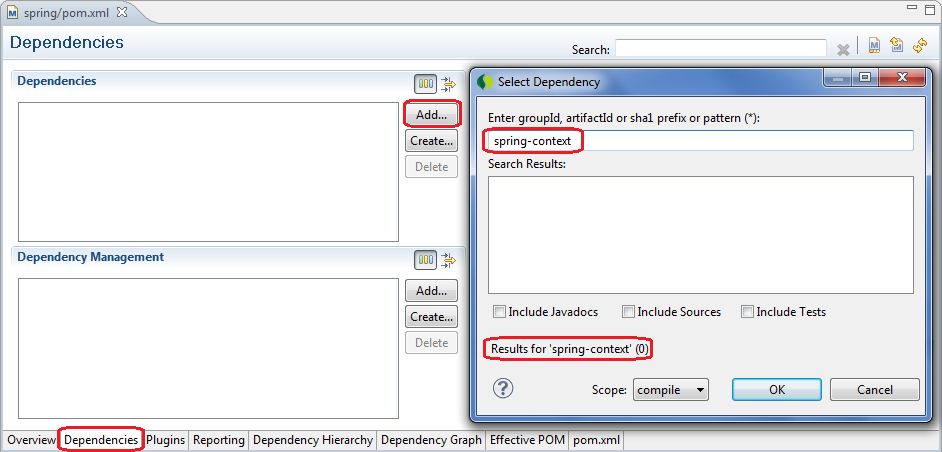
  4. Digite spring-context para adicionar esta dependência ao projeto. Verifique se o Eclipse sugeriu a versão desejada do Spring.
    1. Caso nenhuma sugestão seja mostrada, pode ser que nenhum repositório esteja habilitado, ou que os índices do repositório não tenham sido ainda inicializados. Esta situação é ilustrada na figura abaixo.
    2. Também pode ocorrer de o m2e não sugerir a versão desejada para a dependência. Além da reindexação, pode ser necessário configurar repositórios adicionais de pesquisa.


A view  "Maven Repositories" nos ajudará nesta tarefa. Através dela, é possível saber quais repositórios de dependências estão habilitados, bem como navegar pelos índices desses repositórios:


Note que esta view mostra
  • os artefatos presentes no repositório local (por padrão, o diretório USER_HOME/.m2/repositories)
  • os artefatos do workspace do Eclipse (neste caso, mostra o projeto jms que configuramos como projeto Maven com groupId:artifactId = projeto : projeto)
  • os repositórios globais, onde o repositório central do Maven é mostrado (configurados em USER_HOME/.m2/settings.xml). Note que seu índice está vazio, pois ainda não foi inicializado.
  • os repositórios do projeto, que estiverem configurados no pom.xml (veremos adiante).
Para saber mais sobre os tipos de repositórios, veja http://www.sonatype.com/books/m2eclipse-book/reference/eclipse-sect-repo-view.html.

A figura acima também é muito importante para entender um problema que o Maven resolve para o desenvolvedor: ele baixa automaticamente as bibliotecas e as organiza no diretório USER_HOME/.m2. Simples assim. E ele fará isso automaticamente para todo desenvolvedor que participar do projeto.

Na maioria dos projetos que não utiliza Maven ou algum outro gerenciador de dependências, o desenvolvedor tem que baixar as bibliotecas nos respectivos sites, selecionar os jars e configurá-los para que estejam no ClassPath da aplicação.

Este cenário, além de trabalhoso, é extremamente frágil. Basta que os desenvolvedores usem diferentes IDEs, ou diferentes sistemas operacionais, para inviabilizar o trabalho em equipe. Mesmo na mesma IDE, no mesmo sistema operacional, se o ClassPath da aplicação não estiver corretamente configurado na máquina de cada desenvolvedor, pode ser que a aplicação não funcione para todos no time.

Portanto, se você ainda não usa o Maven, pare de se torturar! Deixe o Maven gerenciar as dependências para vc e para o seu time!


Ao clicar com o botão direito no nome do repositório são mostradas as opções para habilitar o repositório e para indexá-lo. Para este artigo, optei pela opção "Minimum Index Enabled".

Após habilitado, a reindexação ocorre selecionando a opção "Rebuild Index".

Após a indexação, o repositório listará todas as bibliotecas que ele pode prover:


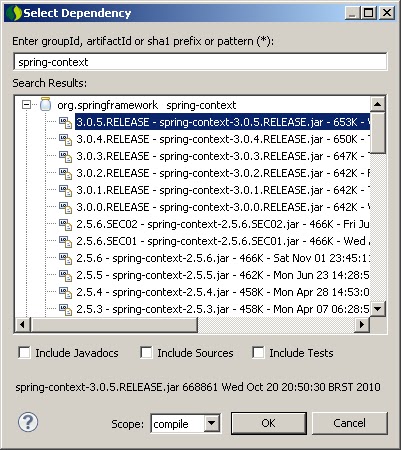
Neste momento, ao tentar adicionar a dependência spring-context, todas as opções (desde os releases mais recentes aos mais antigos) são disponibilizadas:


Similarmente, adicione a biblioteca spring-jms.


Ao salvar o arquivo pom.xml, o Maven baixa as dependências, o que pode ser visualizado no Console Maven do Eclipse:


Após esta operação, o Maven não só terá baixado as dependências, como configurado as dependências do Spring no Build Path do projeto.

Adicionando o ActiveMQ
Neste exercício, será adicionada a dependência ActiveMQ, e mostrar uma das principais armadilhas do uso incorreto do Maven: o de baixar dependências desnecessárias, devido a descuido na hora de selecionar corretamente as dependências.

PQP, o Maven faz backup da Internet no meu micro
Uma das críticas mais comuns que o Maven recebe é o fato de que, mesmo para projetos pequenos (neste momento ainda estamos com o projeto em branco!!!!) ele faz o download de muitos artefatos, antes que o desenvolvedor possa começar a trabalhar.

Isto pode ficar ainda pior, quando as dependências do projeto são mal configuradas, forçando o download de muitos artefatos que não são efetivamente necessários para o projeto. Isto é ruim tanto para os desenvolvedores - que são forçados a esperar o maven fazer downloads demorados após o primeiro checkout do projeto; e também para o build da aplicação, que além de mais demorado, tende a ficar muito maior do que o necessário.

Vamos entender agora porque isso acontece. O principal fator é que os repositórios públicos (como o Maven Central) estão abarrotados de artefatos, e nem sempre é fácil escolher qual o artefato adequado que deve ser utilizado (isto pode ser minimizado caso se decida gerenciar seus próprios repositórios em servidores locais, utilizando o Nexus, algo que poderá ser visto em artigos futuros).

Tomemos o ActiveMQ como exemplo. Veja a extensa lista de artefatos do grupo activemq que podem ser baixados:
Um desenvolvedor desavisado não perderá seu tempo analisando esta lista, e com certeza irá selecionar o primeiro item da mesma. Aí mora a primeira armadilha. Ao optar pela dependência "óbvia", o desenvolvedor acabará baixando mais artefatos do que ele efetivamente precisará, conforme pode ser visualizado na figura abaixo. Apenas para adicionar o ActiveMQ no projeto, foram baixados mais 40 jars!
Aqui nasce uma das maiores dificuldades de se usar o Maven: como escolher o artefato correto? A resposta pode ser difícil no começo, mas com o tempo, esta verificação tende a ficar mais natural.
  • Primeiramente fique atento às dependências Maven listadas no Package Explorer. Caso, ao adicionar uma dependência, muitos jars sejam adicionados (como na figura acima), isto é um mal sinal.
  • Orientações específicas podem ser encontradas nas documentações oficiais, wikis e foruns de cada biblioteca.
  • Quando o eclipse sugerir muitas opções para o mesmo artefato, seja paciente e analise as opções.
    • Evite artefatos com sufixo-all - eles normalmente contém muito mais jars do que o necessário para o projeto.
    • Procure os artefatos de sufixo -core, costumam conter apenas o essencial para a dependência pesquisada.
    • Fique atento à versão do artefato, para não baixar a dependência errada.
    • Consulte índices de repositório, por exemplo http://mvnrepository.com/, https://repository.jboss.org/nexus/index.html e https://ebr.springsource.com.
    • Faça pesquisas no Google ou outro mecanismo de busca, para ver como outros desenvolvedores estão fazendo.

A dependência correta seria org.apache.activemq : activemq-core. Não só a quantidade de jars importados é bem menor, como se descobre que a versão anterior estava totalmente defasada (a versão atual é 5.4.2, enquanto que a que havia sido baixada inicialmente era 3.2.4).
Portanto, ao usar o Maven, selecione cuidadosamente os artefatos necessários para o projeto!

A segunda armadilha pode ser visualizada na figura acima: perceba que a dependência commons-logging foi adicionada duas vezes, uma pelo Spring (commons-logging-1.1.1), e outra pelo ActiveMQ (commons-logging-api-1.1). Isto é ruim não só por aumentar o tamanho do build, como também por adicionar o risco de adicionar exceções em runtime, caso as APIs das versões não sejam compatíveis entre si.

Para remover as duplicações, é necessário configurar exclusões. O processo é bem parecido com a adição de dependências: o Eclipse ajuda a pesquisar / selecionar a exclusão, através do editor pom.xml. Como sempre, selecione cuidadosamente os artefatos para fazer a exclusão correta.


Além de facilitar a configuração de dependências do projeto, o Maven dá de brinde duas facilidades: a aba Dependency Hierachy evidencia as relações hierárquicas entre os jars importados:

Já a aba Dependency Graph exibe estas relações na forma de um grafo:


Conclusão

Espero que as informações o tenha estimulado a adotar o Maven e as facilidades que ele oferece. O Maven é uma ferramenta poderosa que pode auxiliar e muito o setup de projetos em times de desenvolvimento. No entanto, é necessário utilizá-lo com cuidado e bastante atenção, para que erros grosseiros não degradem o ganho de produtividade que ele nos oferece.

O próximo artigo mostrará como utilizar JMS num container Spring, baseado no setup do projeto realizado neste post.