Mostrando postagens com marcador JPA. Mostrar todas as postagens

sexta-feira, 8 de janeiro de 2010

Aplicação de Exemplo usando Hibernate/JPA e DAOs Genéricos

Desafio DF-JUG

Este post foi escrito com o objetivo de responder ao desafio proposto pelo colega Roberto Messa no DFJUG em 07/01/2010. A solução proposta pelo Messa era baseada em JDBC puro, usando DAOs que encapsulavam comandos SQL. Seria interessante se aproveitássemos o desafio para fazer um estudo comparativo entre várias tecnologias, mostrando como cada uma delas soluciona o problema.

Persistence.xml - Configurar a conexão que será usada pela Unidade de Persistência

É o único XML da aplicação, onde configuramos o JPA.

Vantagens

  • caso a aplicação não utilize recursos específicos do BD, para trocar de SGBD basta
    • reconfigurar o dialeto,
    • o driver
    • e a URL de conexão.
  • Não é necessário recompilar a aplicação.
  • O Hibernate gera as tabelas automaticamente... (não preciso das SQL para DDL)

Interface GenericDao.java

Classe JpaDao.java

Fornece a implementação básica do Dao, que pode ser reutilizada para todos os demais. Acabou ficando um pouco extensa, pois incluí nela lógica transacional, estilo BMT (Bean Managed Transactions - soluções declarativas são mais robustas e adequadas, mas para fins didáticos, manterei BMT através do DAO).

Acrescentei no construtor algumas linhas, para o DAO saber qual o tipo genérico com o qual foi parametrizado.

Começa a brincadeira

ProdutoDao

Vazio... (apenas extende e parametriza JpaDao).

Produto.java

Um POJO.... (maior parte gerada usando a IDE - getters, setters e construtores).

Main.java

Respondendo ao desafio:

Saída

Rebatendo desafio, parte 1: Controle de Transações

Caso vc esteja realizando operações que salvam varios registros, e ocorre uma exceção no meio da operação, qual a estratégia? O que foi salvo, continua no BD e o que nao foi salvo se perde? Desfaz todas as alterações? Mesmo usando BMT, que é feio, o exemplo abaixo ilustra essa situação:

Saída

Ou seja, a aplicação chegou a salvar A2 (o ID foi gerado), mas após a exceção em A3, a aplicação fez rollback na transação de desfez todas as operações.

Rebatendo desafio, parte 2: Mais entidades

Vamos "pagar", ou "recuperar o investimento" do código extra de JpaDao na primeira iteração:

ClienteDao.java

Cód. Adicional em Main.java:

Cliente.java é só mais um POJO...

Rebatendo desafio parte 3: Relacionamentos e Cascateamento de Persistência

De uma tacada só, vou salvar um Pedido e seus Itens (OneToMany). Também há métodos adicionais, para calcular total do Pedido.

PedidoDao.java

Pedido.java

ItemPedido.java

Main.java

Em pedidoDao.save, salvo, em uma única linha, 3 objetos: o pedido, e seus dois itens.

Saída

SQL

Eu particularmente só gosto de SQL quando preciso descer no nivel do BD para analisar os dados salvos... Vejamos tudo o que o JPA/Hibernate geraram, sem que eu tenha escrito nenhum SQL em toda a aplicação...

terça-feira, 15 de dezembro de 2009

Seu objeto está na sessão? Entenda o conceito Attached e Dettached Objects!

Esta manhã respondi no RioJUG uma dúvida sobre JPA que achei interessante registrar aqui no blog:

Em JPA, é interessante jogar uma luz sobre um importante conceito: attached/dettached objects. Quando um objeto persistente participa de uma sessão que ainda está ativa, ele se encontra no estado "attached". Depois que a sessão é encerrada (session.close() ou entitymanager.close()), o objeto passa para o estado "detached".

Basicamente, no estado detached, não há mais conexão com o banco, portanto nenhuma alteração realizada no objeto será efetivada no BD, e o objeto não pode mais tentar carregar informações adicionais do banco (por exemplo associações lazy que não tenham sido acessadas durante a sessão).

Estou falando isso, pois o conceito está diretamente vinculado ao papel da chamada merge:

o método recebe um objeto dettached, e retorna o objeto correspondente, vinculado à sessão. Quando o objeto dettached for uma nova entidade, o ORM em algum momento (não necessariamente no momento da chamada) irá realizar um insert no banco de dados. Caso seja uma entidade existente, é interessante obtê-lo através de uma chamada find:

Note que, pelo find, o objeto já é retornado participando da sessão. Uma vez que o objeto já participe da sessão, você pode continuar populando as propriedades desse objeto (attached.setXXX, attached.setYYY), todas as alterações feitas o objeto, DURANTE A SESSÃO serão efetivadas no banco. Resumindo: as alterações realizadas no objeto enquanto ele participa da sessão serão efetivadas no BD.

É legal fazer o seguinte teste: carregue um objeto que já esteja no BD, e realize as alterações nesse objeto. Ao final, apenas feche a sessão, sem a chamada em.merge (ela não é necessária, pois o objeto já estava attached). Logicamente dê commit na transação, caso aplicável. Depois verifique se as alterações foram efetivadas.

Por fim, o JPA fica muito mais divertido e produtivo quando entendemos melhor seu mecanismo de funcionamento, o ciclo de vida dos objetos, pois mapeamento objeto-relacional é seu conceito-base, mas seu poder é com certeza mais amplo.

sexta-feira, 20 de novembro de 2009

Tutorial JPA com Hibernate e SchemaExport (Parte 1)

Fábio Miranda em 18 Out 2008

A JPA (Java Persistence Architecture) é uma poderosa API que o desenvolvedor Java deve dominar. Ela permite que se faça o mapeamento entre um Modelo Orientado a Objetos (OO) e tabelas do Modelo Entidade-Relacionamentos (MER) de um Banco de Dados - em outras palavras, Mapeamento Objeto-Relacional.

Há 3 modos de trabalho: OO >>> MER ou Top Down É sobre esta abordagem que falaremos neste artigo.

OO <<< MER ou Bottom Up Normalmente usado quando se lida com sistemas legados (portanto as tabelas já existem, e há pouca flexibilidade para mudanças nessas tabelas - o modelo OO deve se acomodar ao MER para possibilitar o mapeamento). Pode ser usada também quando se possui uma boa ferramenta de modelagem relacional, e é desejável ter um controle fino da DDL gerada.

OO <<--->> MER ou Meet in the Middle Mesclagem das abordagens anteriores (modela OO, modela ER, realiza mapeamentos (via annotations ou XML), e por fim testa cada entidade para verificar se a persistencia ocorreu conforme desejado).

A abordagem OO >>> MER de longe é a mais interessante das três, permitindo, inclusive, que as tabelas do banco de dados sejam criadas automaticamente, tornando o trabalho muitíssimo produtivo.

Vamos ao que interessa. As ferramentas usadas neste tutorial:

1) Setup

Realize os passos 1 a 3 deste outro post.

2) Configuração JPA no Eclipse

Crie uma pasta lib no seu projeto. Nela, iremos colocar as bibliotecas necessárias para usar o hibernate, para em seguida configurarmos o Build Path (para "importar" as bibliotecas para uso no Eclipse).

Tais bibliotecas podem ser localizadas nos respectivos diretórios descompactados da distribuição Hibernate (exceto as bibliotecas commons, cujas versões mais atualizadas podem ser obtidas no site Apache Commons).

Não podemos esquecer do driver do banco de dados, ou seja copiar C:\JavaDB\lib\derbyclient.jar para Locadora\lib, pois ele será necessário na configuração do Build Path.

Sua pasta lib agora deve parecer como a imagem abaixo:

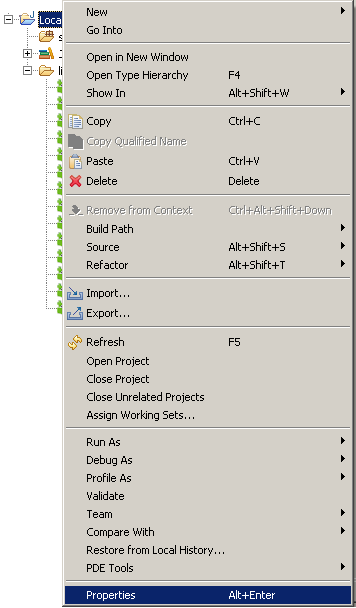
Para configurar o Build Path, clique com o botão direito no nome do projeto e abra a janela de Propriedades

Escolha a opção para adicionar Jars do projeto

Então selecione todos os jars presentes na pasta lib

O projeto com as bibliotecas importadas deve parecer assim:

3) Persistence.xml

O próximo passo será criar o descritor META-INF/Persistence.xml. Mais abaixo segue o código deste descritor, pronto para copiar.

Neste descritor, devem estar presentes todas as informações relevantes para o Hibernate, por exemplo os parâmetros de acesso ao banco de dados. Estes podem ser fornecidos na forma de parâmetros de conexão JDBC (URL, nome do driver, etc...) ou simplesmente por meio do endereço JNDI de um datasource configurado em um Application Server.

Notar a string de conexão com o BD: jdbc:derby://localhost:1527/locadora;create=true.

- jdbc:derby://localhost:1527 informa onde localizar o Derby - locadora é o nome do banco de dados que será criado - create=true é o parâmetro que informa ao derby que, caso o banco não exista, é pra criá-lo.

Além disso, esse descritor permite que habilitemos funcionalidades interessantes, por exemplo SHOW_SQL, que escreve no console todas as queries que o Hibernate executa, e o Schema Export, que falaremos logo adiante.

4) EntityManagerFactory

Neste passo, criaremos uma classe de teste com um método main, apenas para iniciar a Unidade de Persistência que acabamos de configurar no persistence.xml. Note que está destacado em vermelho o nome da unidade de persistência que iremos utilizar (o mesmo nome que também está destadado em vermelho no descritor acima).

Perceba que podemos ter várias unidades de persistência declaradas no persistence.xml, e que elas podem ser consumidas pela aplicação criando a respectiva Fábrica de EntityManagers, conforme o código acima.

Antes de executar o teste, lembre que o banco de dados deve estar rodando. Caso não esteja, execute StartNetworkDerby. Só em seguida execute a classe de teste, clicando com o botão direito no corpo do método main e execute conforme a figura abaixo.

A execução deste teste deve demorar de 5 a 15s, e ao terminar exibe a mensagem "Schema Export Complete"

Como estamos usando o Derby como banco de dados, note que um novo diretório - locadora - é criado. Neste diretório o Derby armazenará todos os arquivos que dizem respeito a esse schema. Para vizualizá-lo, basta clicar no ícone do projeto e pressionar F5.

5) Modelo OO e Mapeamentos OR

Nesta parte 1 da série, mostraremos apenas uma classe simples, e o respectivo mapeamento com as anotações @Entity, @Id, @GeneratedValue e @Transient. No próximo artigo da série, iremos tratar as demais anotações da JPA. Segue abaixo seu código.

Execute novamente a classe Teste. Iremos verificar o que aconceceu com o banco usando através do plugin DTP do Eclipse (leia este post).

Ao mostrar o persistence.xml, lembra que falamos do Schema Export? Ele pode ser configurado via parâmetro do persistence.xml.

Na inicialização do Hibernate (criação da EntityManagerFactory de uma unidade de persistência), o Schema Export pode criar automaticamente as tabelas do banco de dados, a partir de todas as classes anotadas com @Entity, e seus respectivos mapeamentos objeto-relacionais expressos por meio de anotações Java.

Como resultado, foi criada a tabela PERSON, com os campos ID (chave primária ou Primary Key ou PK) e Name, do tipo varchar. Os campos estáticos e transientes de nossa classe não foram mapeados para colunas do banco de dados.

Note o poder que isto representa: trabalhamos o tempo todo com Java, e de quebra ganhamos o banco de dados prontinho para uso!

Neste artigo, tivemos todo o cuidado de fazer um tutorial hands-on, que qualquer javeiro consiga executar. Nos próximos artigos desta série, iremos nos preocupar apenas com os conceitos Objeto-Relacionais de JPA, mostrando como as classes, hierarquias de classes e relacionamentos são mapeados para tabelas e colunas do banco de dados. E melhor: tudo de forma automática, com o Schema Export que acabamos de mostrar.

Anotations serve para que?

Fábio Miranda em 22 Set 2008

http://tech.groups.yahoo.com/group/riojug/message/21020

O melhor exemplo que me vem à cabeça é JPA.

Antes:

Depois:

Multiplique isso num sistema com 50 entidades...

Ou seja: Do modo tradicional, para cada entidade do sistema, é necessário manter um arquivo em XML que faz o mapeamento objeto-relacional.

Com annotations, você lida apenas com a classe Java, e "Anota" aquilo que vc teria de fazer via XML.

Vantagens de Annotations: - Menos artefatos para dar manutenção. - Mais fácil de refatorar. - Programação "por Convenção" - p. ex., todos os atributos da sua classe são "convencionalmente" entendidos como colunas do mapeamento, exceto quando forem estáticos ou transientes. (no xml, todo atributo teria de ser mapeado para uma coluna).

Desvantagens: é intrusiva, ou seja, o código fica "recheado" de "configurações" que não necessariamente têm a ver com o domínio do problema - ou em outras palavras, revelam detalhes de implementação.

Integração Spring x JPA

Por Fábio Miranda, em 19 Fev 2008

Os primeiros parágrafos contém o "resumo da ópera". Em seguida, um pouco de código exemplificando as opções de integração.

DAOs que usam JPA necessitam de EntityManagerFactories (EMFs) e/ou EntityManagers (EMs) para realizar as operações num bancos de dados.

O Spring Framework gerencia objetos, podendo resolver dependências entre eles. Caso o Spring gerencie a(s) EMFs e os DAOs, ele pode injetar os EMFs nos DAOs, de forma transparente ao código. Então, a primeira coisa a se aprender é como fazer o Spring gerenciar a(s) EMF(s).

Uma vez configurados os beans necessários no Spring, pode-se partir para o código. É possível usar JPA com Spring de forma desacoplada, através de anotações JPA (desde que configure o Spring para reconhecer tais anotações); ou de forma acoplada, usando APIs especializadas do Spring.

DUMMY STEP) Para integrar JPA com Spring, logicamente é necessário um projeto JPA (grosso modo: entidades devidamente anotadas, e um arquivo META-INF/persistence.xml). Exemplo de projeto:

  • src
    • br.com.airframes
      • Product.java
    • META-INF
      • persistence.xml

1) Configuração recomendada da EMF (LocalContainerEntityManagerFactoryBean)

Esta maneira é a mais flexível e poderosa. A linha "load-time-weaver" refere-se a questões de instrumentação de código requeridas por alguns provedores de persistência. Não será necessária quando o provedor é o Hibernate, por isso deixei comentada.

Note que está comentada a linha da propriedade dataSource. Por default, o Spring usa as configurações de acesso ao banco presentes em persistence.xml. Porém, vc pode deixar que o Spring também gerencie o seu datasource (ignorando persistence.xml), conforme item 6 deste tutorial.

2) Declarar um DAO como bean do Spring, no qual será injetada a EMF:

3) Integração de Baixo acoplamento usando anotações (Plain JPA)

3.1) Para o Spring reconhecer as anotações JPA, declarar:

ou

3.2) Codificação do Dao

Pronto! Esta é a maneira mais poderosa de integrar Spring e JPA, sem que haja qualquer dependência ao Spring explícita no código Java. A Spring Framework desempenha seu papel de forma transparente, injetando o EntityManagerFactory num mecanismo possível graças a anotações e ao PersistenceAnnotationBeanPostProcessor.

4) Outras maneiras de o Spring gerenciar o EMF.

Há duas maneiras alternativas àquelas apresentadas no passo 1 deste tutorial:

4.1) No caso da aplicação rodar em um App Server, é preferível deixar o Spring localizar o EMF na árvore JNDI:

É necessário também cuidado especial com a instrumentação de código, de modo que ela não entre em conflito com as bibliotecas do App Server. (consultar documentação do Spring).

4.2) LocalEntityManagerFactoryBean ao invés de LocalContainerEntityManagerFactoryBean

É a forma mais simples porém mais limitada de integrar JPA ao Hibernate. Ela não dá suporte, por exemplo, a transações globais. Seu uso é recomendado em aplicações simples que usam apenas JPA para acessar dados. Pode ser muito útil em aplicações standalone e ambientes de teste.

5) Integração Altamente Acoplada ao Spring

Neste caso, lida-se com JpaTemplates no lugar de EntityManagers, pois JPATemplate encapsula o EntityManager (JPATemplate gerencia internamente o EntityManager, não expondo-o ao programador).

Desta forma, como o código Java deixará de usar a API EntityManager, deve-se:

- Remover as declarações do item 3.1 deste tutorial (annotations post processors).

- Reescrever a configuração do DAO, possibilitando injeção do EMF via setter:

- Escrever método setter no DAO possibilitando o Spring injetar a dependência:

Dispostas as linhas gerais, seguem as opções para este tipo de integração:

5.1) Declarar JpaTemplate explicitamente em cada DAO da aplicação

5.2) Herdar JpaDaoSupport

JpaSupportDao já fornece o jpaTemplate, e setter para injeção do EntityManagerFactory, sem que necessidade de escrever código redundante nos DAOs

5.3) E quando precisar acessar a EntityManager API diretamente?

Escrever subclasses de JpaCallback e executá-los em JpaTemplates. Ao fornecer um JpaCallback, JpaTemplate executará o método doInJpa(EntityManager em) passando como parâmetro a sua referência interna da EntityManager.

Essa abordagem possibilita ao programador acesso indireto à EntityManager (através de um Callback). Para não inchar o sistema com estas subclasses, é possível usar herança implícita no código.

O código abaixo reescreve doSomething com Callbacks que permitem acessar o EntityManager.

6) Datasource gerenciado pelo Spring

6.1) Spring localiza datasource no JNDI

6.2) Spring lida diretamente com datasource

(Usa DBCP como Pool de Conexões - pode ser substituída por outra segundo preferência - por exemplo o C3P0).

Para configurar um datasource na JNDI, é necessário consultar a documentação do app server / container web.

Para o Tomcat: Tomcat-JNDI HowTo.

A biblioteca Simple-Jndi permite implementar uma árvore JNDI em aplicações stand-alone (pode ser útil em casos de testes).

Bibliografia http://static.springframework.org/spring/docs/2.5.x/reference/orm.html#orm-jpa http://static.springframework.org/spring/docs/2.5.x/reference/jdbc.html